Ошибка приоритизации при внедрении ИИ: почему найм AI-специалистов до инженеров данных обрекает компании на провал
В гонке за скорейшее внедрение ИИ компании совершают одну и ту же критическую ошибку: она может стоить им миллионов долларов, потраченных на неудачные проекты и упущенные возможности. Последние данные по рынку найма показывают тревожную тенденцию: организации нанимают AI-специалистов беспрецедентными темпами, при этом игнорируя базовые роли, связанные с инфраструктурой данных, без которых успех ИИ попросту невозможен.
Это похоже на найм гонщиков до строительства гоночной трассы: на бумаге выглядит впечатляюще, но на практике почти гарантированно приводит к провалу.
Тревожная статистика провалов AI-проектов
Цифры по текущему состоянию внедрения ИИ в корпоративной среде выглядят мрачно. Согласно исследованию RAND, более четырёх из пяти AI-проектов не оправдывают возложенных на них ожиданий. Уровень неудач превышает 80% — это примерно вдвое выше, чем у традиционных ИТ-проектов, и заставляет всерьёз задуматься о том, как именно компании подходят к внедрению ИИ.
Что же становится причиной этих провалов? Дело вовсе не в сложности AI-моделей или ограничениях алгоритмов машинного обучения. Истинная причина куда более фундаментальна: качество данных, их доступность и управление ими. Почти две трети организаций (63%) признают, что не уверены в собственных возможностях управления данными в контексте AI-инициатив. Однако, судя по структуре найма, многие компании так и не связали эти факты между собой.
Недавние данные по рынку труда США от DoubleTrack это подтверждают. В период с 2024 по 2025 год американские работодатели разместили 111 296 вакансий для AI- и ML-специалистов, но лишь 76 271 вакансию, ориентированную на инженерную инфраструктуру данных. Разрыв в 46% между AI-ролями и позициями в области инженерии данных отражает фундаментальное непонимание того, что именно делает AI-проекты успешными.
Феномен «найма роботов до механиков»
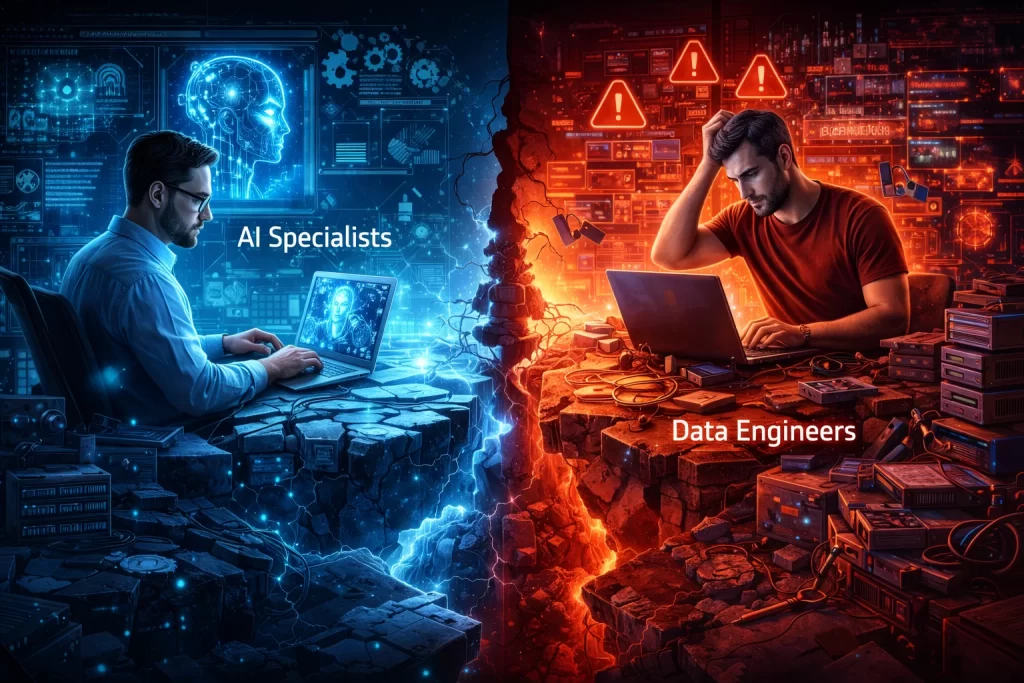
Этот перекос в найме объясняется простой аналогией: компании фактически нанимают «роботов», не позаботившись о том, чтобы в штате были «механики», способные их обслуживать.
AI-специалисты — это заметное и привлекательное лицо цифровой трансформации. Это инноваторы, от которых ожидают революции бизнес-процессов и появления новых источников дохода. Инженеры данных, напротив, остаются за кадром: они строят пайплайны, обеспечивают качество данных и поддерживают инфраструктуру, без которой ИИ не может функционировать.
Проблема проявляется по-разному в различных функциях бизнеса, но паттерн остаётся неизменным. В подразделениях продаж компании разместили на 232% больше вакансий, связанных с ИИ, чем позиций в области инфраструктуры данных. Это особенно тревожно, учитывая, что данные из CRM-систем известны своей фрагментированностью, несогласованностью и низким качеством. Данные о продажах часто содержат дубликаты, разные форматы, неполные записи и противоречивую информацию в разных системах. Именно такие проблемы обрекают AI-проекты на провал ещё на старте.
У маркетинговых подразделений баланс лучше, однако и здесь ИИ-позиции превышают роли по данным на 54%. Это лучше, чем в продажах, но всё равно говорит о смещении приоритетов в сторону AI-возможностей при недостаточном внимании к качеству данных.
Инженерные, юридические и технологические подразделения дают похожую картину: найм в сфере ИИ стабильно опережает найм специалистов по инфраструктуре данных. При этом каждый из этих департаментов работает с разными типами данных и сталкивается со своими специфическими проблемами качества, однако фокус по-прежнему смещён в сторону ИИ, а не фундамента.
География AI-хайпа: где проблема проявляется острее всего
Географический разрез добавляет к картине важную деталь. Самое высокое соотношение AI-ролей к позициям в области инфраструктуры данных наблюдается не в традиционных технологических центрах вроде Калифорнии, Нью-Йорка или Массачусетса. Напротив, лидируют регионы, которые обычно не воспринимаются как технологически зрелые:
- Миссисипи — на 264% больше AI-ролей, чем позиций по данным
- Миссури — 179%
- Канзас — 176%
- Монтана — 175%
Такое распределение говорит о том, что регионы с менее сформированной технологической экосистемой сильнее подвержены хайпу вокруг ИИ. В погоне за внешним эффектом они начинают нанимать AI-специалистов, не создав предварительно необходимую инфраструктуру. В этих регионах может не хватать опытного руководства, понимающего зависимость ИИ от качества данных, либо присутствует давление «выглядеть инновационными», не осознавая реальных технических требований.
Более зрелые технологические хабы тоже не лишены дисбалансов, но в целом их пропорции выглядят здоровее. Это, вероятно, отражает накопленный институциональный опыт и лучшее понимание реальной сложности внедрения ИИ.
Компенсационная головоломка
Ситуацию усугубляет и структура вознаграждений. В среднем AI-специалисты получают примерно на 15 000 долларов в год больше, чем инженеры данных. Получается, компании платят более высокую зарплату тем специалистам, которые не способны обеспечить результат без надлежащего фундамента.
Этот разрыв в компенсациях посылает рынку чёткий сигнал: работа в ИИ считается более ценной, чем инженерия данных. В результате таланты уходят из фундаментальных ролей, а организационные перекосы в пользу «видимого» ИИ лишь усиливаются.
Почему это происходит
Проблема видимости
AI-проекты хорошо заметны. Анонс новой AI-инициативы вызывает энтузиазм у стейкхолдеров, впечатляет инвесторов и легко превращается в маркетинговый нарратив. Проекты по инфраструктуре данных лишены такого эффекта: надёжные пайплайны, governance и контроль качества данных не становятся поводом для громких пресс-релизов.
Недооценка сложности
Многие руководители воспринимают инженерию данных как относительно простую задачу, нечто вроде ETL-процессов, которые можно быстро «закрыть». В реальности современная инженерия данных — это сложные распределённые системы, потоковая обработка, фреймворки качества данных, управление метаданными, интеграция разрозненных источников и обеспечение безопасности.
Дефицит технической экспертизы у руководства
Решения о найме и бюджете часто принимаются людьми без глубокого технического бэкграунда. Они читают о трансформационном потенциале ИИ в бизнес-медиа, но не понимают его технологических предпосылок. В результате приоритет отдаётся эффектному результату (ИИ), а не необходимому фундаменту (данные).
Давление выглядеть инновационными
Компании испытывают сильное давление демонстрировать инновационность. Найм AI-специалистов служит внешним сигналом прогресса, в то время как найм инженеров данных такого эффекта не даёт. Особенно это характерно для конкурентных рынков и компаний, привлекающих инвестиции.
Реальные последствия
Потраченные инвестиции
Когда AI-проекты терпят неудачу из-за слабого дата-фундамента, компании теряют не только деньги, вложенные в зарплаты AI-специалистов. Потери включают расходы на облачную инфраструктуру, лицензии, обучение персонала и альтернативные издержки. Такие провалы легко обходятся в миллионы долларов без какой-либо бизнес-ценности.
Разочарование и текучесть талантов
Квалифицированные AI-специалисты быстро разочаровываются, обнаружив, что 70–80% их времени уходит на очистку и подготовку данных. Это работа, для которой они часто избыточно квалифицированы и к которой не готовились. Результат — выгорание, текучесть кадров и замкнутый круг повторного найма.
Потеря конкурентных позиций
Пока одни компании борются с провалившимися AI-инициативами, конкуренты, инвестировавшие в данные, получают реальные результаты: быстрее масштабируются, внедряют более сложные модели и достигают измеримого бизнес-эффекта.
Организационный цинизм
Повторяющиеся неудачи формируют скепсис по отношению к новым инициативам. Команды теряют доверие, руководители разочаровываются в технологиях, а организация вырабатывает «иммунитет» к инновациям. Такой культурный урон может сохраняться годами.
Путь вперёд: стратегия data-first при внедрении ИИ
Начните с оценки данных
Прежде чем нанимать хотя бы одного AI-специалиста, компании должны провести тщательную оценку текущего ландшафта данных: качество, доступность, интеграции, governance, инфраструктуру и разрыв между текущим состоянием и реальной готовностью к ИИ.
Установите правильные пропорции найма
Вместо текущего перекоса в 46% организациям следует стремиться как минимум к паритету между инженерами данных и AI-специалистами на ранних этапах. В реальности более здоровым соотношением часто является 2:1 или даже 3:1 в пользу инженерии данных.
Инвестируйте в управление данными заранее
Управление данными — это не только про соответствие регуляторным требованиям. Это про надёжность, согласованность и пригодность данных для обучения моделей. Необходимы чёткое владение данными, стандарты качества, мониторинг, lineage, безопасность и защита приватности.
Формируйте кросс-функциональные команды
Наиболее успешные AI-инициативы строятся на тесном взаимодействии инженеров данных, AI-специалистов, бизнес-экспертов и предметных специалистов. Изоляция AI-команд почти всегда приводит к провалам.
Инфраструктура — прежде инноваций
Компании должны сопротивляться соблазну сразу внедрять самые продвинутые AI-техники. Сначала необходимы стабильные пайплайны, мониторинг качества данных, масштабируемая инфраструктура хранения и обработки, инструменты self-service и надёжные механизмы безопасности.
Обучайте руководство
Ключевой фактор успеха — понимание руководством того, что ИИ невозможен без данных. Осознание зависимостей, сроков и реальных инвестиций значительно повышает вероятность правильных стратегических решений. На этом этапе часто помогает взгляд со стороны: например, партнёр по внедрению ИИ и ML быстрее указывает на пробелы в данных, чем внутренняя команда, увлечённая самой AI-частью проекта.
Роль моделей зрелости ИИ
Организациям стоит ориентироваться на модели зрелости, признающие данные фундаментом ИИ:
Этап 1: Фундамент данных — сбор, хранение, базовое качество.
Этап 2: Аналитика, описательная и диагностическая.
Этап 3: Предиктивная аналитика — прогнозирование будущих результатов.
Этап 4: Прескриптивные системы, рекомендации действий.
Этап 5: Автономные системы — минимальное вмешательство человека.
Попытка перескочить через этапы почти гарантированно ведёт к провалу.
Предупреждение Gartner: обрыв 2026 года
Gartner предупреждает: три из пяти AI-проектов без готовых для ИИ данных будут закрыты к 2026 году. Готовность данных означает не просто их наличие, а чистоту, управляемость, безопасность, интеграцию и соответствие задачам ИИ.
Компании, игнорирующие эти требования, с высокой вероятностью пополнят статистику 60% закрытых инициатив.
Отраслевые особенности
Разные отрасли сталкиваются со своими вызовами:
у финансов это регуляторика и lineage,
у здравоохранения — конфиденциальность и разрозненные данные пациентов,
у ритейла — потоковая обработка онлайн- и офлайн-данных,
у промышленности — IoT-данные и интеграция OT/IT-систем.
Лучшие практики успешных организаций
Компании, успешно внедрившие ИИ, начинают с конкретных бизнес-кейсов, инвестируют в данные до масштабирования ИИ, формируют кросс-функциональные команды, измеряют успех бизнес-результатами и относятся к качеству данных как к постоянной дисциплине.
Заключение: пересмотр приоритетов найма
Текущий перекос в сторону найма AI-специалистов отражает фундаментальное заблуждение о том, как должно выглядеть внедрение ИИ. Компании пытаются строить дом, начиная с крыши. Те, кто продолжит гнаться за хайпом, рискуют остаться в числе 80% неудач. Те же, кто сделает ставку на данные, получат устойчивые конкурентные преимущества.
Вопрос не в том, нужен ли ИИ.
Вопрос в том, готов ли фундамент.