
CodeMender — что это и как его применять при разработке программного обеспечения
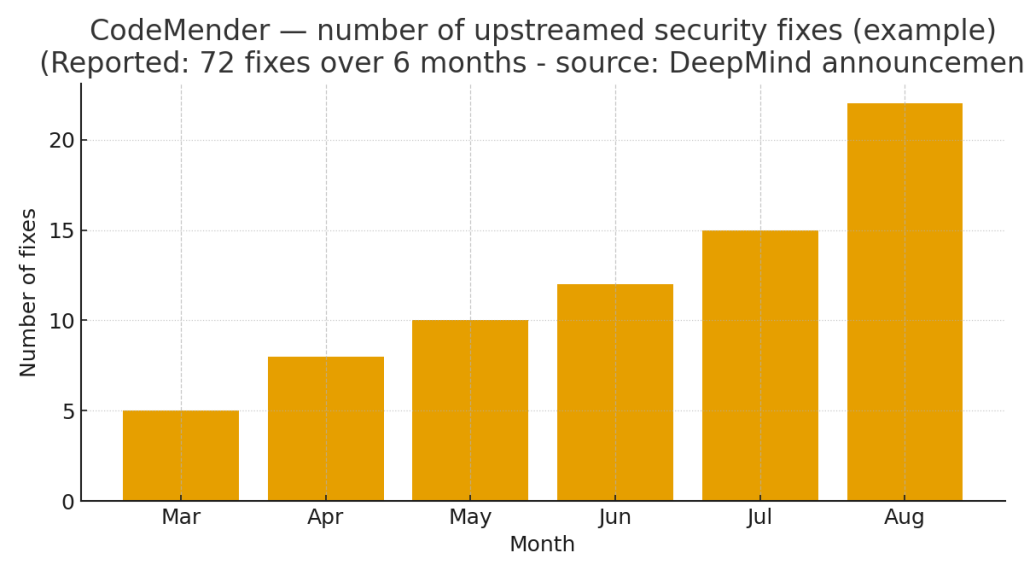
CodeMender — агентная система для безопасности кода: она сочетает крупные модели кода и языка с инструментальной верификацией (статический и динамический анализ), тестированием (fuzzing, unit-тесты) и обязательным участием человека в процессе. Находит уязвимость, предлагает патч, проверяет его и в части случаев сама открывает pull request в исходный репозиторий — так называемый upstream-фикс. По данным DeepMind и Google, счёт таких исправлений уже идёт на десятки: в первом отчёте компания упоминает 72 upstream-патча за первые месяцы работы CodeMender.
Откуда появилась идея и почему это важно
Современный софт — это миллионы строк кода и тысячи зависимостей, которые меняются каждый день. SAST, DAST и фаззеры находят уязвимости, но дальше начинается ручная работа: triage, правка, повторное тестирование, на это уходят недели. С появлением мощных LLM и их сочетанием с программным анализом задача сдвинулась на следующий уровень: не просто найти брешь, а гарантированно или приближённо безопасно её закрыть — это направление называют автоматизированным исправлением уязвимостей (Automated Vulnerability Repair). Исследования 2025 года по моделям CodeT5, CodeBERT и гибридным подходам фиксируют реальный прогресс, но и ограничения: генерализация на новые классы багов пока хромает.
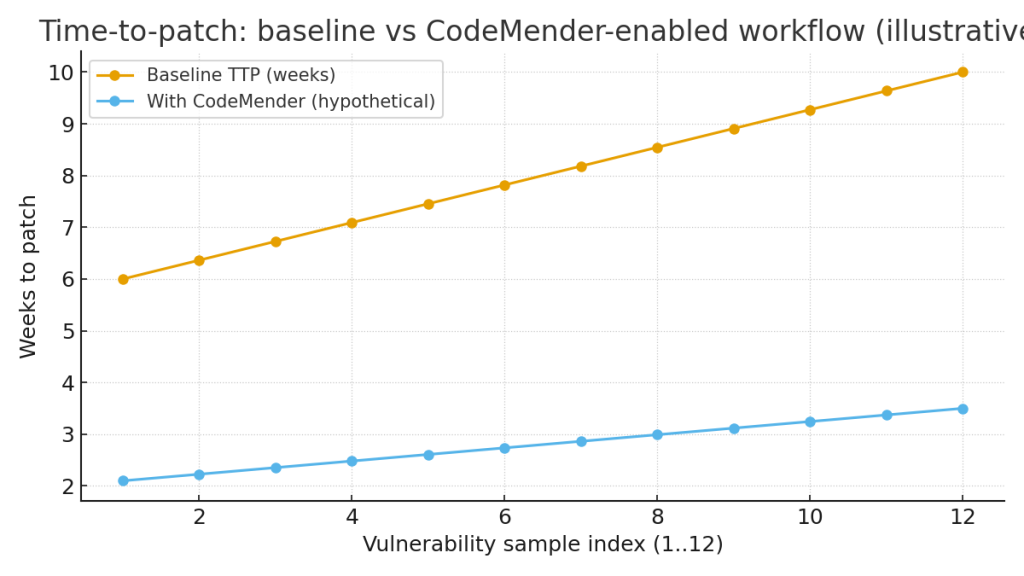
CodeMender — практическое воплощение этой идеи. Агент локализует проблему, генерирует патч, проверяет его набором unit- и regression-тестов вместе с эвристиками и дальше либо применяет патч сам, либо выставляет MR/PR на ревью. За счёт такого цикла время от обнаружения уязвимости до исправления сокращается, а это один из ключевых показателей безопасности.
Что это даёт на практике:
- Сокращается time-to-patch (TTP): окно для эксплойта закрывается быстрее;
- Растёт масштаб ремедиации: автоматически закрывается больше мелких проблем;
- Высвобождается время разработчиков: они переключаются на архитектуру и сложные задачи;
- Для upstream-проектов ускоряется исправление уязвимостей в open source: компания заявляет о десятках таких фиксов в реальных репозиториях.
2. Как работает CodeMender: архитектурное представление (high-level)
Если разложить систему на слои, получится такая картина:
- Data & Signal Aggregation
Сюда стекаются результаты SAST (например, CodeQL), данные динамического анализа, crash-репорты, находки фаззинга, тикеты, баг-репорты и телеметрия исполнения — логи, метрики. По этим сигналам агент вычисляет «patch surface» — небольшой участок кода, который нужно поправить. - Root-cause локализация и контекст
Агент разбирает стек ошибки, смотрит тесты и историю коммитов, поэтому понимает не только где баг, но и почему он вообще появился. - Candidate Fix Synthesis (генерация фикса)
Модель предлагает один или несколько вариантов патча: от точечной замены строки до безопасного рефакторинга, добавления валидации входных данных или изменения API-контракта. - Automated Verification
Здесь система жёстче всего: патч прогоняют через unit- и интеграционные тесты, fuzz-корпуса, статический анализ, property-based тесты. Для отдельных классов багов — race condition, buffer overflow — подключают символический анализ или формальную проверку. Пометку «candidate for merge» или «auto-apply» патч получает только после того, как прошёл весь набор проверок. - Human-in-the-loop & Governance
Дальше следует ревью человеком: maintainer или security-инженер вместе с governance-слоем решают, применять патч автоматически, открыть PR или отложить. Так снижается риск сломать рабочую логику и соблюдается политика компании — SLA, compliance. - Upstreaming & Disclosure Workflows
Для open source агент умеет сам собрать PR и сопутствующий CVE/issue-документ, что упрощает исправление уязвимостей во внешних репозиториях. По данным DeepMind, немалая часть автоматических фиксов уже прошла upstream.
3. Где и как CodeMender приносит реальную пользу командам разработки
3.1. В CI/CD pipeline (вариант интеграции)
- Pre-merge: статический и динамический анализ прямо в PR. Агент запускается на уровне CI, разбирает изменённый код и предлагает исправление тут же, комментарием или дополнительным патчем. Так меньше шансов пропустить уязвимость в релиз.
- Post-merge / Production-monitoring: если сигнал приходит из логов или мониторинга уже после релиза, агент быстро готовит патч и открывает emergency PR, а до полного тестирования может подключить правило WAF или feature-flag.
На практике CodeMender имеет смысл подключать как отдельный security-job в CI (GitHub Actions, GitLab CI, Jenkins), который срабатывает по расписанию и на каждый security alert. Для критичных репозиториев автоприменение стоит разрешать точечно, по политике «доверенные репозитории / только критичные патчи».
3.2. В командной разработке
- Security-инженеры вместо голых отчётов о проблемах получают готовые candidate-патчи: triage занимает заметно меньше времени.
- Разработчики получают рабочий патч с пояснением и тестами: проще понять, в чём была причина бага, и быстрее принять изменение.
3.3. Для поставщиков программного обеспечения и OEM
- В коммерческих продуктах CodeMender может встроиться в pipeline доставки патчей: собирать hotfix-пакеты и предлагать staged rollout (сначала canary, потом полный релиз) с мониторингом регрессий.
4. Риски, ограничения и когда CodeMender не заменит человека
У автоматизации хватает сильных сторон, но и ограничений тоже.
4.1. Ограничения моделей
- LLM и код-модели время от времени «галлюцинируют»: предлагают патч, который выглядит убедительно, но ломает логику приложения. Поэтому верификация — тесты, статический анализ — не опция, а обязательный шаг.
4.2. False positives / Overfitting
- Агент способен подогнать фикс под конкретный тест-корпус, который в реальном окружении проблему не решает. Спасают широкие тестовые наборы плюс property-based тестирование.
4.3. Governance и доверие
- Автоматическая правка кода в критичных сервисах без чётких правил — прямой путь к регрессиям в проде. Нужно заранее решить: кто вправе разрешать автоприменение, какие классы уязвимостей обязательно идут на human review, как устроен rollback.
4.4. Безопасность самой системы
- CodeMender сам по себе — компонент инфраструктуры, и его окружение тоже нужно защищать: RBAC, безопасное хранение секретов, аудит логов. Утечка модели или инструментария может раскрыть внутренние паттерны кода и обернуться реальным вредом.
Практическая инструкция: как безопасно внедрить CodeMender-подобную систему (пошагово)
Дальше следует пошаговый план внедрения для enterprise, который легко адаптировать под свою инфраструктуру.
Шаг 0. Планирование и политика
- Зафиксируйте SLA, уровни доступа и критерии автоприменения.
- Составьте governance-документ: какие репозитории и какие классы уязвимостей идут на автоприменение, а какие — только через ревью.
Шаг 1. Подготовка инфраструктуры
- CI/CD: выделите отдельный security-pipeline.
- Environment: отдельный runner/agent с урезанными правами: чтение репозитория, запись только через PR.
- Секреты: только через vault (HashiCorp, облачный KMS).
- Monitoring: подключите лог-агрегатор и настройте алерты на аномалии после релизов.
Шаг 2. Интеграция источников сигналов
- Подключите SAST (CodeQL, Semgrep), DAST, fuzzing, crash-репорты, баг-трекер и телеметрию.
- Настройте нормализацию сигналов, иначе агент не расставит приоритеты правильно.
Шаг 3. Определите рабочие сценарии (playbooks)
- Emergency hotfix: agent генерирует patch → runs tests → opens PR with high priority label → security oncall получает уведомление.
- Scheduled maintenance: agent запускается раз в неделю на low risk repos и складывает патчи в backlog для review.
Шаг 4. Верификация и тестирование
- Подготовьте тестовые плейбуки: unit, integration, regression, fuzz corps.
- Добавьте policy: patch must pass N unit tests + pass fuzzing for X minutes.
Шаг 5. Запуск в режиме «human review»
- На старте все патчи без исключения идут через security engineer или maintainer. Считайте соотношение полезных патчей и ложных срабатываний, это покажет, когда контроль можно ослаблять.
Шаг 6. Постепенная автоматизация
- Когда система стабильно держит низкий уровень regressions, для простых классов (input validation, null checks, bounds checks) можно включать автоприменение через feature flags.
Шаг 7. Обучение и обратная связь
- Обучите разработчиков и security-team работать с патчами: как читать объяснения агента, воспроизводить изменения локально и делать rollback.
Типичные сценарии применения / примеры патчей
Вот типичные правки, которые CodeMender генерирует чаще всего:
- Input validation — проверка длины и формата данных перед их использованием, профилактика SQLi и XSS.
- Safe API usage — замена небезопасных вызовов API на безопасные, например устаревших insecure-функций.
- Resource management — исправления для утечек памяти и файловых дескрипторов через корректное закрытие handle.
- Race fix — локи или изменение порядка операций, чтобы устранить TOCTOU.
- Access control — усиленные проверки прав на критичных путях: кто отправитель, кто владелец.
- Sanitization for serialization — защита от object injection безопасной десериализацией.
Каждый такой патч сопровождается тестом (новым или изменённым), чтобы предотвратить регрессии.
Метрики и KPI для оценки эффекта
Чтобы понять реальную выгоду от CodeMender, стоит следить за набором метрик:
- Time-to-patch (TTP) — среднее время от обнаружения уязвимости до выпуска исправления. CodeMender должен снижать этот показатель. (Иллюстрация в картинках выше.)
- Number of vulnerabilities closed per month — сколько дефектов закрывается в месяц, upstream и в собственных репозиториях. (DeepMind: 72 upstream-фикса — ориентир первых месяцев.)
- False positive rate / regression rate — доля предложенных патчей, которые привели к регрессиям.
- Developer time saved — сколько часов triage и патчинга освободилось для feature work.
- Coverage of verification tests — какая доля предложенных фиксов покрыта автоматическими тестами.
Пример интеграции: GitHub Actions + CodeMender (псевдо-workflow)
- Trigger: PR or scheduled nightly job.
- Сбор сигналов: запускается SAST (CodeQL), прогоняется тест-suite, собирается телеметрия.
- Agent run: CodeMender анализирует результаты, генерирует candidate patch.
- Verification: в контейнере запускаются unit tests и fuzzing.
- If pass → create PR with patch and test results; notify security team.
- If fail → create issue with diagnostics and suggested human-guided fix.
Правила безопасности и соответствия
- Audit trail: каждое действие агента логируется и подписывается.
- PII handling: если диагностика использует реальные логи, персональные данные обязательно маскируются.
- Legal & Licensing: автопатчи для open source требуют проверки лицензий и прав на contribution (CLA).
- Vulnerability disclosure process: агент встраивается в процесс CVE/PSIRT и трекинг.
Примеры успешных кейсов (обобщённо из анонса и публикаций)
- DeepMind и Google сообщают о 72 upstream-фиксах в разных проектах за первые месяцы — конкретное доказательство, что агент способен масштабно помогать в реальной экосистеме open source.
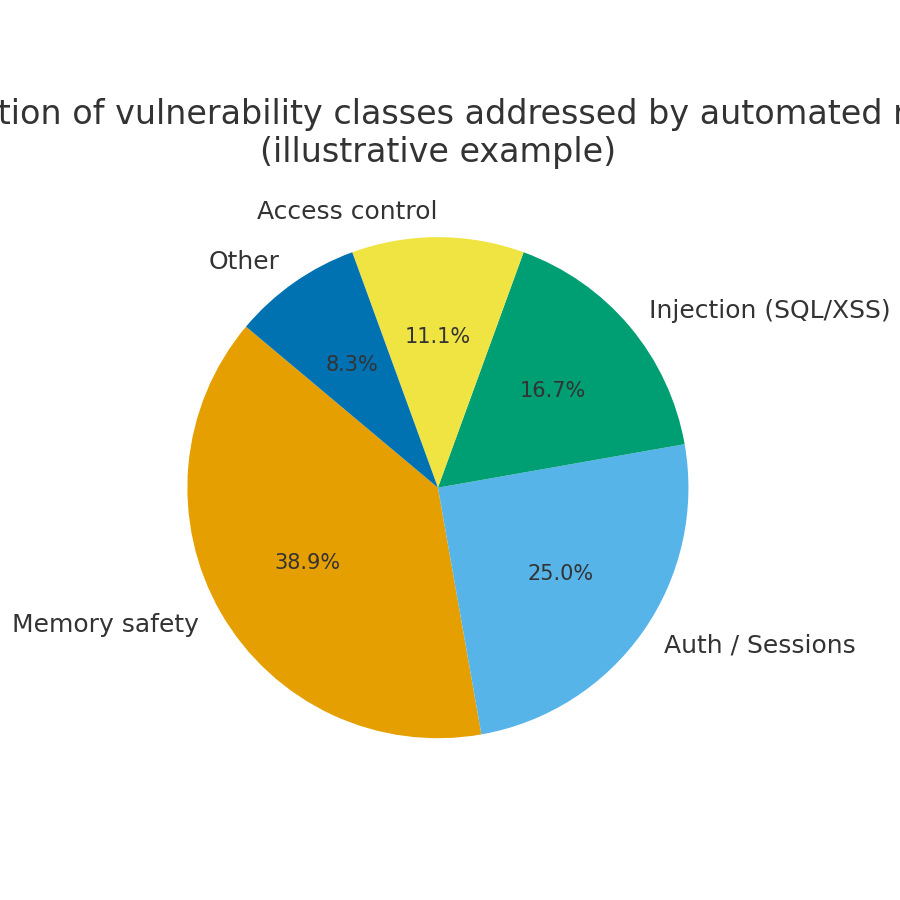
- Отраслевые публикации отмечают: связка LLM и классического анализа находит и правит дефекты быстрее традиционных инструментов в ряде категорий — memory safety, authentication bugs.
Как подготовить репозиторий, чтобы CodeMender (или подобный агент) работал лучше
- Мощный набор тестов: unit + integration + e2e + fuzz-tests; чем шире покрытие — тем безопаснее автопатчи.
- Чистая архитектура и код-стиль: читаемый код проще анализировать, значит быстрее находится корень проблемы.
- Документация входных предположений: контракт-описания API, примеры входов/выходов помогают агенту предлагать корректные фиксы.
- Тестовые окружения и reproducibility: контейнеризация, reproducible builds для воспроизведения багов.
- CI orchestration hooks: скрипты, которые автоматически прогоняют тесты для предложенных патчей.
Практические примеры проверки и валидации патча (checklist для security engineer)
- Прогонять unit tests:
pytest/go test/mvn test - Прогонять integration tests в staging
- Запуск fuzzing на ограниченном наборе сценариев (10–60 минут per patch)
- Static analysis on patched files (CodeQL, clang-tidy, etc.)
- Canaries: deploy patch на 1–2% трафика и мониторинг ошибок/latency/metrics
- Rollback автоматический при резком росте ошибок
Автоматические проверки закрывают типовые классы багов, но сложные цепочки эксплуатации по-прежнему находит только человек, поэтому критичные сервисы стоит регулярно прогонять через пентест независимо от того, насколько активно используется CodeMender.
Будущее автоматизированной ремедиации и роль разработчика
CodeMender — важный шаг в эволюции безопасности ПО: от «человека-охотника за багами» к «агенту-ремонтёру». Роль человека при этом не исчезает, она смещается: инженеры остаются главным фильтром качества, бизнес-владельцы — источником политик, а security-команды — инстанцией, ответственной за governance.
Академические исследования сходятся в одном: автоматическое исправление хорошо дополняет ручное ревью, но не заменяет его полностью, особенно там, где критична бизнес-логика, а формальных проверок недостаточно.
Резюме и рекомендации (конкретные действия на ближайшие 30–90 дней)
- Оцените текущий security-pipeline: есть ли SAST/DAST/fuzzing и насколько они интегрированы с CI.
- Соберите тест-корпус: unit и integration тесты остаются основой безопасных автопатчей.
- Запланируйте пилот: выберите 2–3 не критичные репозитория и подключите agent в режиме human-review.
- Метрики: определите KPI (TTP, закрытые уязвимости, regressed patches).
- Постепенно расширяйте: после успешного пилота переходите к автоматизации для low-risk патчей.
Если своей экспертизы для внедрения агентных систем пока не хватает, разумно подключить команду с опытом внедрения ИИ и ML в реальные процессы разработки — это ускорит пилот и снизит число ошибок на старте.
Заключение
CodeMender — символ новой волны инструментов, которые не только находят уязвимости, но и помогают их исправить с гораздо меньшими затратами времени и усилий. При грамотной валидации, governance и тестовой культуре организационный эффект может быть значительным: снижение времени реакции на инциденты, масштабирование исправлений и повышение устойчивости ПО.
Ключ к безопасному использованию — сочетание автоматизации и человеческого контроля: агентов нужно подвергать строгой верификации, а их права и зоны автоприменения — ограничивать политикой организации. Построив такой баланс, команды получают преимущество в скорости, не жертвуя качеством.