
Zero Trust для ИИ: почему модель «никому не доверяй» — ключ к безопасности LLM и агентов
Коротко: принцип «никогда не доверяй, всегда проверяй» давно стал базовым для современных инфраструктур. Но когда к системам добавляются LLM и автономные AI-агенты с доступом к данным и API, старая парадигма периметра перестаёт работать: ИИ умеет агрегировать, анализировать и действовать на больших объёмах данных за секунды, а значит любая уязвимость масштабируется не в десятки записей, а в тысячи или миллионы. Именно поэтому Zero Trust для ИИ, модель, построенная на идентичности и минимальных правах, — сегодня не абстрактная идея, а практическая необходимость для безопасного развёртывания AI. (Основа темы: TechRadar.)
Главная проблема: ИИ увеличивает число путей для атак и масштаб ущерба
LLM и автономные агенты усиливают знакомые риски, но каждый по-своему:
- Масштаб и скорость. Агент с доступом к API способен выполнить цепочку запросов и за секунды собрать множество конфиденциальных записей. Одна скомпрометированная сессия, и объём утечки становится огромным.
- Сложные цепочки действий. Агенты вызывают других агентов, сервисы, базы данных, и отследить, «кто чего попросил», становится всё сложнее.
- Новые «не-человеческие» идентичности. Сервисные аккаунты, токены, модельные учётки (non-human identities, NHIs) часто получают постоянные и широкие права, за которыми плохо следят.
Вывод простой: традиционных периметров и статических фильтров (фильтрация prompt/output) уже недостаточно. Нужны идентично-ориентированные, контекстно-чувствительные микроправила, которые ограничивают доступ по действию, по времени и по контексту.
Что такое Zero Trust в контексте ИИ
Классические принципы ZT остаются на месте, просто адаптируются под ИИ-контекст:
- Каждое действие требует идентификации и авторизации. Не только человек: модель, агент, процесс тоже имеет собственную идентичность, роли и права.
- Контекстные, тонкие политики доступа. Доступ зависит от времени, роли, локации, метаданных сессии и категории данных.
- Минимальные права плюс JIT (just-in-time) доступ. Права на действие выдаются только тогда, когда это действительно нужно, и отзываются сразу после.
- Аудит и неизменяемые логи. Каждая цепочка вызовов между агентами, моделями и данными должна быть записана и проверяема.
- Контроль цепочек (propagation control). Если агент вызывает другого агента, система обязана проверять полномочия на каждом шаге и не передавать по цепочке «статус суперпользователя».
Эти положения логично вытекают из NIST SP 800-207 — базового руководства по Zero Trust. В контексте AI управляющую часть нужно усилить именно для non-human identities и механизмов JIT/PAM.
Где Zero Trust даёт самый большой эффект: кейсы и аргументы
a) Предотвращение exfiltration через агента
Если у агента по умолчанию нет «standing privilege», промт-инъекция не даст прав на выгрузку базы: злоумышленник может заставить модель сформировать запрос, но без валидной идентификации на стороне API доступ будет запрещён.
b) Контроль автоматических цепочек действий
Zero Trust позволяет подписывать и прослеживать полномочия вместе с запросом: агент A может прочитать метаданные, но не экспортировать платёжные данные; агент B может создавать тикеты, но только в песочнице.
c) Ограничение вреда при компрометации токенов
JIT-доступ вместе с ревокацией и «песочницами» (scoped tokens) сокращает время жизни украденных токенов и область их действия.
Технические элементы внедрения Zero Trust для ИИ на практике
Дальше — конкретные блоки архитектуры и шаги, которые понадобятся на практике.
Идентичность для моделей и агентов (NHIs)
- У каждого агента и модели должна быть своя identity в IAM: client_id, mTLS-сертификат, short-lived token.
- Принцип простой: нет пользователя — нет и полномочия, сервисные аккаунты должны иметь минимальный набор прав.
Примеры и решения в индустрии есть: Okta и другие IAM-платформы уже встраивают инструменты управления не-человеческими идентичностями и JIT PAM.
Политики доступа и атрибуция (policy engine)
- Используйте policy engines (OPA, XACML, облачные аналоги) для динамического запрета или разрешения.
- Политики должны учитывать sensitivity labels (PII/PHI), источник запроса, контекст текущей сессии.
Just-in-Time (JIT) и least privilege / PAM
- Для критичных операций вызывайте approval workflow (human-in-the-loop) или выдавайте временные права.
- Интегрируйте PAM, чтобы выдавать привилегии только на короткое время.
Observability и неизменяемый аудит
- Логируйте цепочки: кто → агент → модель → ресурс, с подписью и таймстампом.
- Используйте WORM-хранилище для логов и SSO-инструменты, чтобы ссылаться на конкретную сессию.
Контроль содержимого и RAG-изоляция
- Для Retrieval-Augmented Generation (RAG) стройте отдельную прослойку: проверяйте, какие документы модель может подхватить и какие фрагменты разрешено возвращать.
- При необходимости используйте «filters + redactors» и динамическое маскирование PII.
Процесс внедрения: roadmap, шаги и приоритеты
- Discovery & Inventory. Найдите все NHIs (сервисные аккаунты, модели, агентов) и точки интеграции AI.
- Классификация данных. Определите, какие данные критичны и какие запреты или разрешения им нужны.
- Identity baseline. Выдайте идентичность в IAM/PKI каждому агенту.
- Пилот с policy engine. Настройте OPA или облачные политики для нескольких рабочих потоков (например, summary of contracts).
- PAM + JIT. Настройте получение прав по заявке и автоматический отзыв.
- Observability & incident playbooks. Настройте алерты и runbooks на случай подозрительных цепочек доступа.
- Развёртывание и масштабирование: по вертикалям и по степени риска.
- Audit / continuous improvement. Регулярные оценки, red team/blue team и тесты на prompt injection и agent jailbreak.
KPI и метрики успеха: чем измерять
- TTR (time-to-revoke): среднее время от обнаружения скомпрометированного токена до его отзыва.
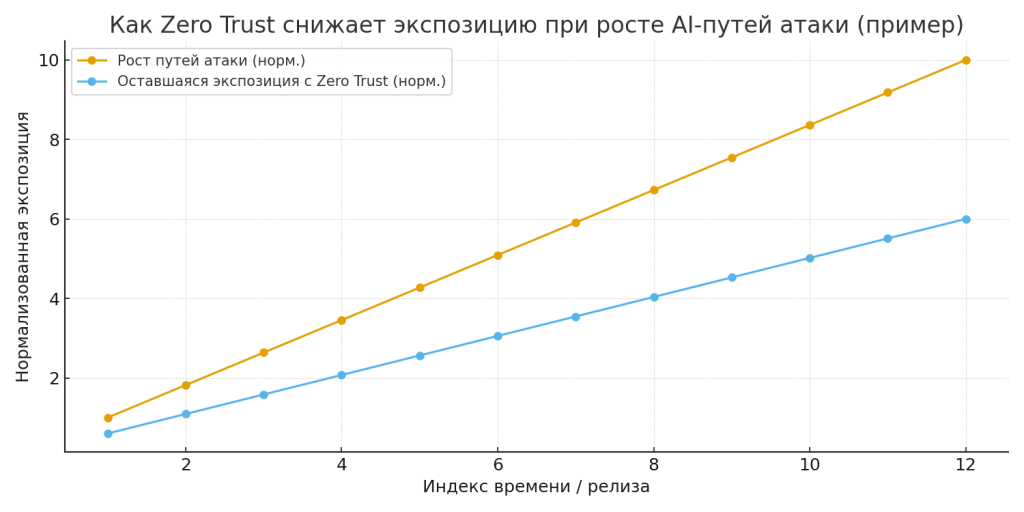
- Снижение зоны экспозиции: доля запросов, которые получили бы доступ в legacy-системе, но блокируются ZT (в процентах).
- Количество инцидентов утечки через AI-агентов: абсолютная и относительная динамика.
- Процент транзакций с JIT-авторизацией: практическая мера охвата PAM.
- Время реакции на аномальную цепочку вызовов: SLA SOC / AI security.
Регуляторный ландшафт и требования: как это влияет на rollout
Регуляторы, включая требования GDPR и инициативы по AI-гарантиям, уже выдвигают чёткие ожидания: организация должна уметь доказать, кто и почему получил доступ к данным, какие меры приняты против неправомерного использования моделей. Zero Trust даёт готовую фактуру для auditable controls: identity, scope, logging, minimization. Всё это помогает соответствовать требованиям. Внедряя ZT, компания получает не только техническую защиту, но и юридическую доказуемость своих действий.
Прогнозы и сценарии на 2025–2029 годы: аналитика и цифры
Дальше собраны реалистичные сценарии и связанные с ними прогнозы. Это иллюстративные оценки, основанные на рыночных публикациях и текущих трендах в IAM/Zero Trust:
Сценарий 1. Ускоренное принятие (оптимистичный)
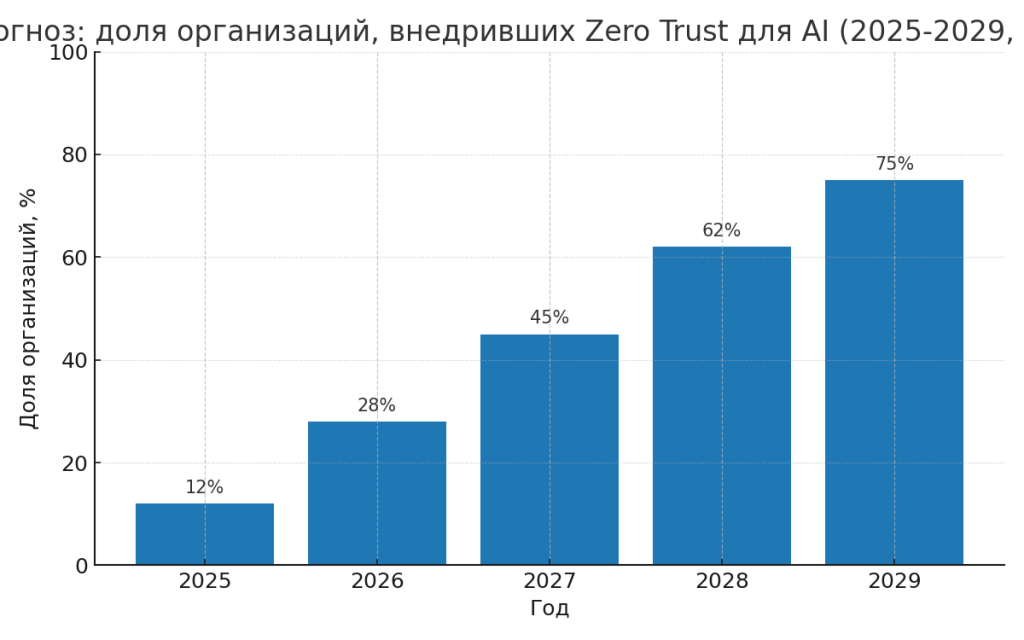
- 2025: пилоты и early adopters, 12–20% крупных предприятий.
- 2026–2027: быстрый рост, 30–50% организаций в облачной среде внедрят основные ZT-контроли для AI.
- 2028–2029: 60–80% зрелых цифровых организаций будут использовать ZT-паттерны специально для AI-каналов (график прогноза в картинках).
Сценарий 2. Регулируемая зрелость (пессимистичный)
- Из-за строгих локальных правил (ЕС, здравоохранение) внедрение в этих секторах идёт медленнее: 20–30% к 2027 году.
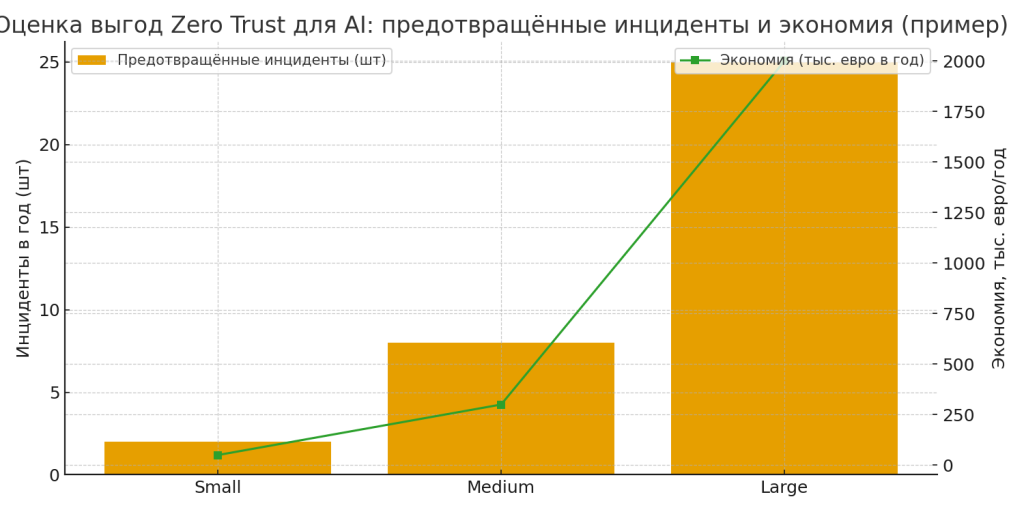
Влияние на инциденты и экономику (примерные оценки): если организация сократит зону экспозиции AI на 60% благодаря ZT, потенциальное число инцидентов, связанных с утечкой через агентов, может упасть в 3–5 раз. Прямые экономические потери (штрафы, remediation, репутационный урон) могут сократиться на сопоставимый коэффициент. (См. иллюстративную диаграмму выгод.)
Практические рекомендации: что сделать завтра
- Составьте реестр NHIs: инвентаризацию сервисных учёток, моделей, токенов.
- Сегментируйте доступ. Операции с PII, платежами и критичными данными выносите в отдельный сегмент с повышенным контролем.
- Внедрите JIT-доступ для операций с высокими рисками.
- Подключите policy engine (OPA или облачный эквивалент), чтобы управлять всем из одного места.
- Настройте неизменяемую трассировку цепочек вызовов: «agent A запросил X; agent B выполнил Y».
- Регулярно тестируйте prompt injection и agent jailbreak с привлечением red-team.
- Установите бизнес-метрики и SLA: TTR, процент автодоступов, число инцидентов.
На этом этапе имеет смысл привлечь профильную команду: кибербезопасность ИИ-инфраструктуры — не та область, где стоит полагаться только на внутренние ресурсы, особенно если своей практики red team пока нет.
Ограничения и риск «переусложнения»
Zero Trust — не магическая кнопка. Его внедрение требует усилий: согласования политик, переработки сервисной архитектуры, обучения команд. Неправильная настройка может привести к отказу сервисов и росту операционной нагрузки. Поэтому оптимален подход «пилот → автоматизация → расширение»: начать с пары критичных рабочих потоков и постепенно масштабировать.
Заключение: почему стоит начать сейчас
AI даёт огромные выгоды, но одновременно увеличивает масштаб ущерба от ошибок и злоупотреблений. Zero Trust для ИИ — проверенная архитектурная парадигма, которая естественно переводит безопасность в модель, пригодную для машинной скорости решений: выдача прав по требованию, динамическая авторизация, слежение и ретроспективная проверка. Организации, которые заранее выстроят идентичностно-ориентированную защиту и JIT-контроль для AI, получат конкурентное преимущество — они смогут быстрее масштабировать AI-инициативы, одновременно снижая риск утечек и регуляторных штрафов.