
Обзор лучших LLM для разработчиков
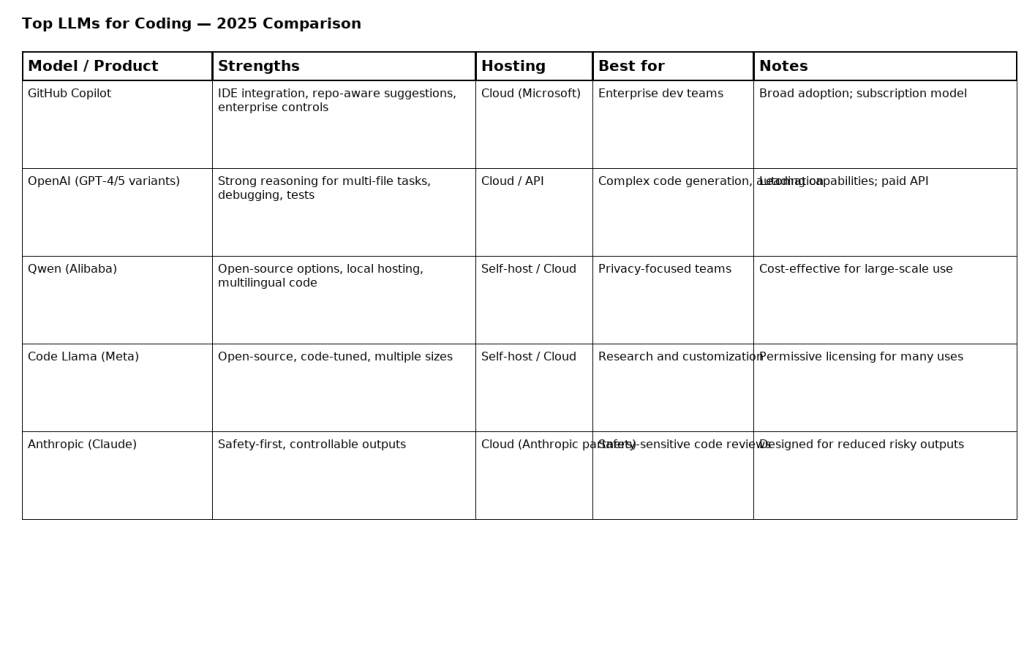
AI-ассистенты для разработки кода давно перестали быть игрушкой: в 2024–2025 годах они стали частью повседневной работы программистов. Разобрались, какие LLM для разработчиков сейчас лучшие: что умеют современные модели, чем Copilot отличается от Qwen3-Coder и Code Llama, и куда всё это движется дальше. Модели уже не просто пишут функции по подсказке, они учитывают содержимое репозитория, предлагают исправления, генерируют тесты и помогают в ревью.
Что вообще умеют кодовые LLM
- Генерация и автодополнение: от отдельной функции до целого шаблона файла.
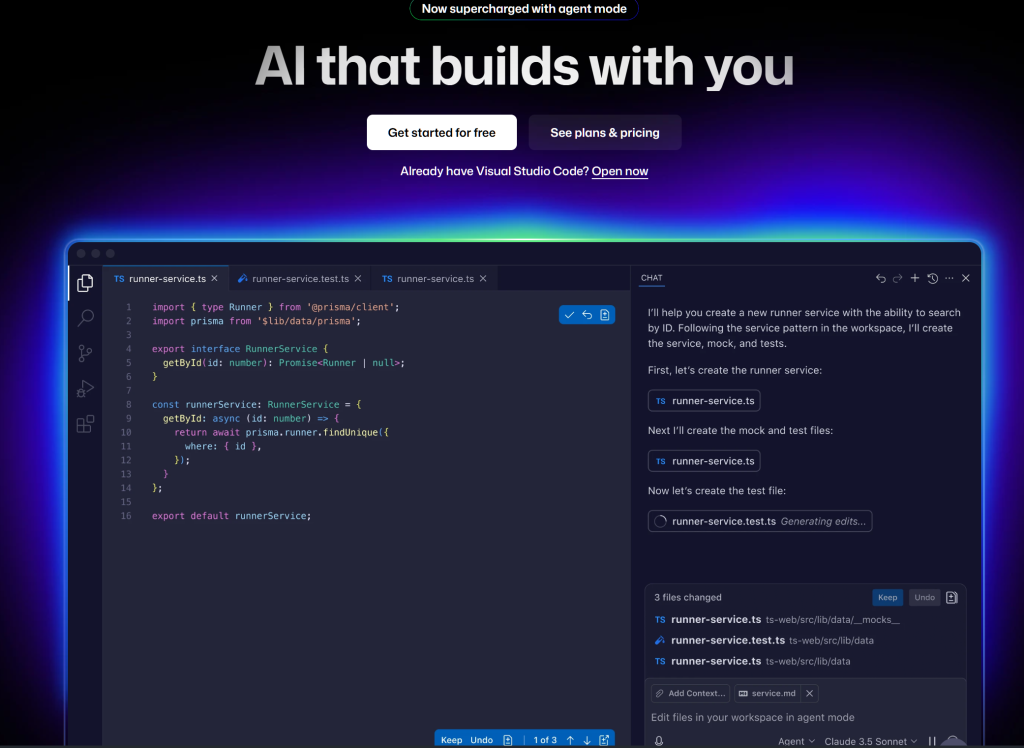
- Контекст-чувствительные подсказки: модель учитывает код в репозитории, тесты, докстроки.
- Отладка и объяснение ошибок: предлагает исправления и объясняет, почему упал тест.
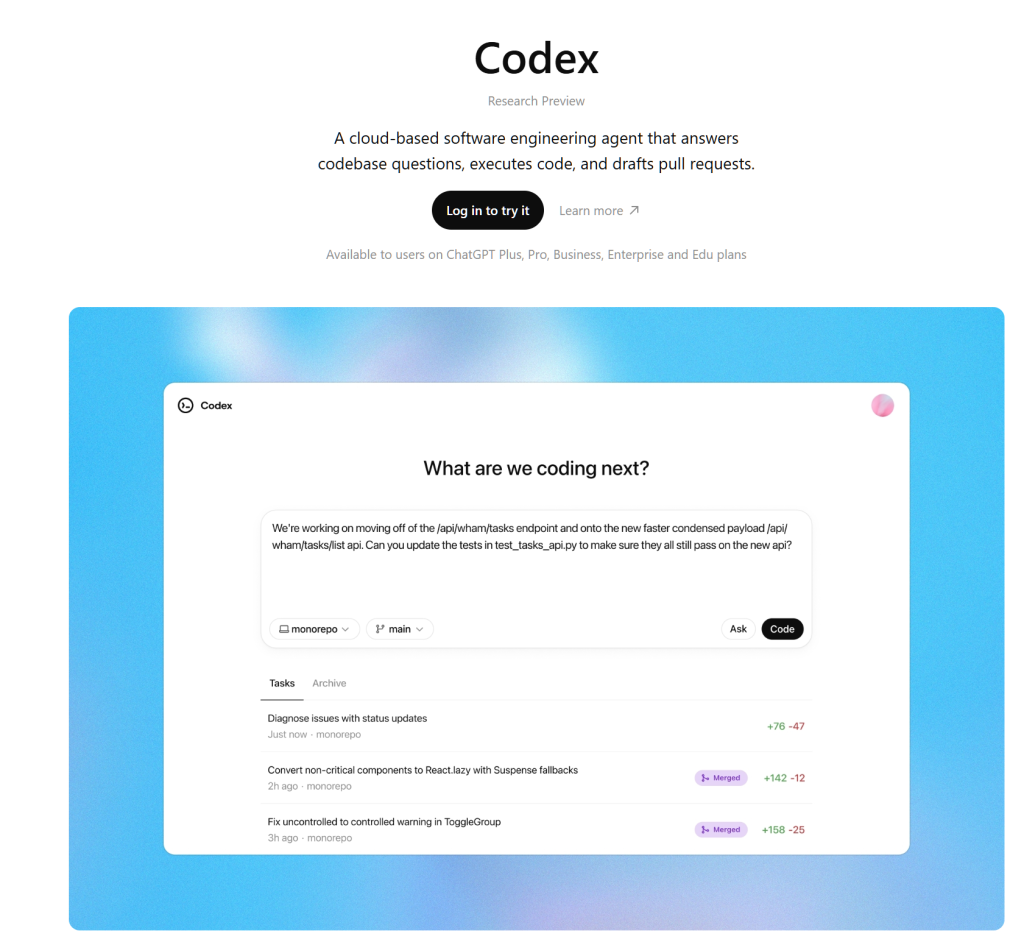
- Агентные сценарии: способна сама запускать тесты, чинить код и повторять цепочку действий (agentic workflows).
Обзор лучших LLM для разработчиков в 2025 году
GitHub Copilot — «рабочая лошадка» для команд
Copilot плотно встроен в IDE: VS Code, JetBrains и другие, с настройками для бизнеса и управлением данными. По отчётам Microsoft и GitHub, у него уже больше 20 млн зарегистрированных пользователей, а пользуются им около 90% компаний из списка Fortune 100. Для корпоративной команды это, по сути, выбор по умолчанию.
OpenAI (GPT-семейство, кодовые варианты)
У OpenAI Codex сильная сторона — генерация сложных многомодульных решений, рефакторинг и агентные сценарии. Улучшения модели дают в первую очередь контекст и логику, которые пригождаются на больших задачах по архитектуре и отладке. Коммерческие API-решения при этом остаются облачными и платными.
Qwen / Qwen3-Coder (Alibaba) — локальный и масштабируемый
Alibaba активно развивает линейку Qwen, включая Qwen3-Coder, агентную модель с расчётом на большие контексты, корпоративное использование и локальное развёртывание. Это позволяет работать с закрытыми репозиториями, не отправляя код в публичное облако.
Code Llama (Meta) — открытый и настраиваемый
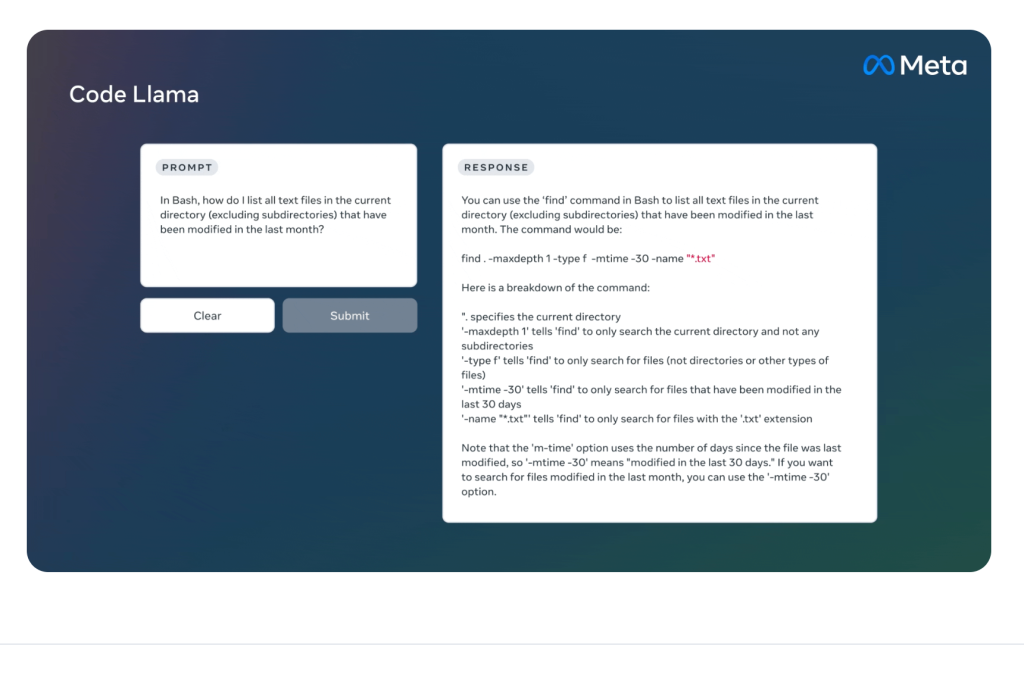
Code Llama и вся линейка Llama — open-source-подход: модели можно запускать локально, дообучать под свои данные и встраивать в собственные пайплайны. Meta продолжает развивать Llama, наращивая контекст и мультимодальность.
Anthropic (Claude) — безопасность и управление
Anthropic делает ставку на «безопасность по умолчанию» и предсказуемое поведение модели. Интеграции Claude в офисные и IDE-решения нацелены на enterprise-задачи с повышенными требованиями к комплаенсу и аудиту, а партнёрства с крупными вендорами двигают безопасных агентов в корпоративную разработку.
На что смотреть при выборе модели
- Скорость и качество автодополнения: насколько редко приходится переписывать сгенерированный код руками.
- Насколько хорошо модель держит контекст всего репозитория, а не только открытого файла.
- Понятность объяснений при отладке: не просто «вот патч», а почему именно упал тест.
- Готовность к агентным сценариям: способна ли модель сама прогонять тесты и править код, а не ждать команды на каждый шаг.
Несколько интересных фактов и инсайтов
- GitHub Copilot перешёл отметку в ~20 млн пользователей, а доля использования в компаниях Fortune 100 заявлена на уровне 90%, и по этим цифрам видно, насколько корпорации уже зависят от автогенерации кода в 2025 году.
- Модели нового поколения вроде Qwen3-Coder проектируют с огромными контекстными окнами: сотни тысяч токенов, а с методами экстраполяции модель может добраться и до миллионов. Это меняет сценарии использования: теперь модель способна «видеть» весь репозиторий и тест-сьюты целиком.
- Open-source-экосистема (Code Llama / Llama 4) тоже не стоит на месте: семейство Llama развивает нативную мультимодальность и длинные контексты, а локальные развёртывания становятся мощнее и практичнее.
- Заметен тренд на сращивание LLM с классическими SDLC-инструментами: автоматические ревью, сканирование на уязвимости, синтез патчей. Партнёрства вроде Anthropic и IBM для интеграции в IDE ускоряют внедрение таких сценариев в крупных компаниях.
Практический чеклист — как выбрать и внедрить LLM для команды
Если это первое системное внедрение AI-ассистентов в разработку, полезно опираться на опыт команд, которые занимаются внедрением ИИ и ML не первый год. Ниже чек-лист, с которого стоит начать.
- Определите требования к данным: можно ли отправлять репозиторий в облако или нужен on-premise?
- Запустите пилот и измеряйте время разработки, количество исправленных багов, качество автогенерации (coverage тестов).
- Политика безопасности: настройте запрет на отправку секретов, используйте DLP и прокси-логирование запросов.
- CI/QA-шлюзы: любые изменения, сгенерированные моделью, должны проходить автоматические тесты и ревью человеком.
- Отслеживайте происхождение кода: фиксируйте, какой моделью сгенерирован фрагмент, это важно для лицензирования и аудита.
- Планируйте апдейты и валидацию: модель устаревает, поэтому регулярно проводите оценку качества и проверку на bias и уязвимости.
Прогнозы (2025–2026)
- Агентность станет нормой. Инструменты будут не просто предлагать код, а самостоятельно собирать тесты, прогонять CI, исправлять и предлагать PR-шаблоны (человеческая проверка останется обязательной).
- Открытые модели поднимут планку локального хостинга. Llama-семейство и Qwen позволят компаниям снизить затраты и соответствовать требованиям регуляторов.
- Появятся стандарты валидации кода. «Проверочные конвейеры» для AI-генерированного кода: автоматические тесты, статический анализ, проверка лицензий.
- Появятся новые рабочие роли: инженеры, которые умеют «оценивать модели», prompt-инженеры, AI-ревьюверы, специалисты по валидации безопасности кода.
Риски — не игнорируйте их
- Генерация уязвимостей: LLM могут синтезировать небезопасный код или подтянуть устаревшие библиотеки, поэтому автоматический сканинг обязателен.
- Лицензирование: фрагменты, сгенерированные моделью, могут перекликаться с обучающим корпусом. Важно вести учёт и применять сканеры лицензий.
- Переизбыточное доверие: разработчики склонны принимать первый результат не глядя, поэтому стоит ввести правило «проверил — принял».
Заключение
Рынок кодовых LLM быстро дозревает: интеграция в IDE, расширенные контексты, агентные цепочки и массовое корпоративное внедрение — это уже рабочая реальность 2025 года, а не футуристика. На практике выигрывают команды, которые сочетают удобные облачные инструменты (Copilot, OpenAI) с локальными «резервными» моделями (Qwen, Code Llama) и строят над ними надёжные валидационные пайплайны и политики безопасности. Из всего разбора видно, какие LLM для разработчиков сейчас реально лучшие под разные задачи: вот сводная картина.
- Интеграция IDE: Copilot > OpenAI > сторонние плагины для Qwen/Code Llama.
- Возможность self-host: Qwen, Code Llama сильно опережают OpenAI/Anthropic/Copilot, которые по умолчанию облачные.
- Готовность для предприятия: Copilot и OpenAI лидируют (SLA, биллинг, DLP-опции).
- Безопасность: Anthropic фокусируется на guardrails; GitHub предлагает опции отказа от использования данных для обучения.
- Стоимость: открытые локальные модели снижают API-расходы, но повышают требования к инфраструктуре.